RAG(検索拡張生成)
LLMの知識は、学習されたデータに限定されます。
LLMにドメイン固有の知識や独自データを認識させたい場合は、次の方法があります:
- RAGを使用する(このセクションで説明します)
- 独自データでLLMをファインチューニングする
- RAGとファインチューニングの両方を組み合わせる
RAG とは?
簡単に言うと、RAGとは、LLMにプロンプトを送信する前に、データから関連情報の断片を見つけてプロンプトに注入する方法です。
これにより、LLMは(できれば)関連情報を取得し、その情報を使って回答できるようになり、幻覚(ハルシネーション)の可能性を減らすことができます。
関連情報の断片は、さまざまな 情報検索 メソッドを使用して見つけることができます。 最も一般的なものは次のとおりです:
- 全文(キーワード)検索。この方法は、TF-IDFやBM25などの技術を使用して、 クエリ(例:ユーザーが尋ねている内容)内のキーワードをドキュメントのデータベースと照合してドキュメントを検索します。 各ドキュメント内のこれらのキーワードの頻度と関連性に基づいて結果をランク付けします。
- ベクトル検索(「セマンティック検索」とも呼ばれます)。 テキストドキュメントは、埋め込みモデルを使用して数値のベクトルに変換されます。 次に、クエリベクトルとドキュメントベクトル間のコサイン類似度 またはその他の類似度・距離尺度に基づいてドキュメントを検索・ランク付けし、 より深いセマンティックな意味を捉えます。
- ハイブリッド。複数の検索方法(例:全文+ベクトル)を組み合わせると、通常、検索の効果が向上します。
現在、このページは主にベクトル検索に焦点を当てています。
全文検索とハイブリッド検索は、現在、Azure AI Search統合とElasticsearchでのみサポートされています。
詳細については、AzureAiSearchContentRetriever と ElasticsearchContentRetriever を参照してください。
近い将来、RAGツールボックスに全文検索とハイブリッド検索を含める予定です。
RAG のステージ
RAGプロセスは、インデックス作成と検索の2つの明確なステージに分かれています。 LangChain4jは、両方のステージのツールを提供します。
インデックス作成
インデックス作成ステージでは、検索ステージ中に効率的な検索が可能になるように、ドキュメントが前処理されます。
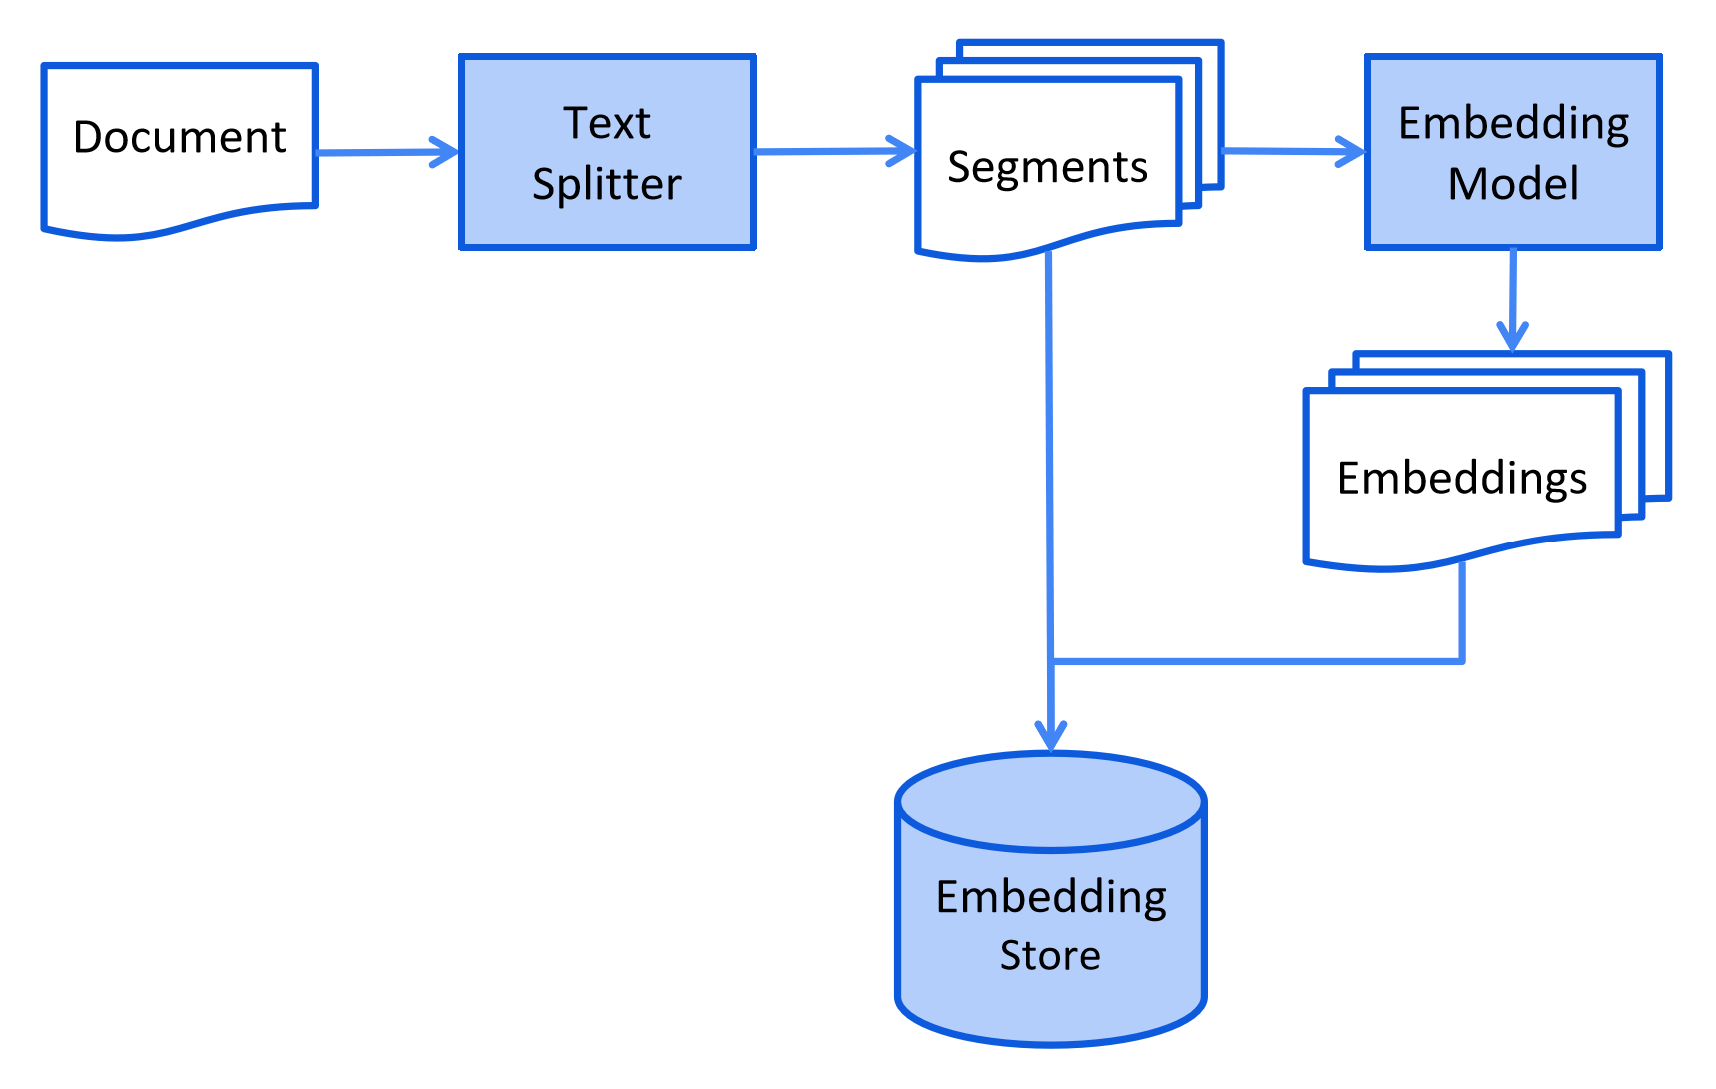
このプロセスは、使用される情報検索方法によって異なります。 ベクトル検索の場合、通常、ドキュメントのクリーニング、追加データとメタデータの強化、 ドキュメントをより小さなセグメントに分割(チャンキングとも呼ばれる)、これらのセグメントの埋め込み、そして最後に埋め込みストア(ベクトルデータベースとも呼ばれる)への保存が含まれます。
インデックス作成ステージは通常オフラインで行われ、エンドユーザーが完了を待つ必要はありません。 これは、例えば、週末に社内ドキュメントを週に1回再インデックスするcronジョブによって実現できます。 インデックス作成を担当するコードは、インデックス作成タスクのみを処理する別のアプリケーションにすることもできます。
ただし、一部のシナリオでは、エンドユーザーが独自のドキュメントをアップロードしてLLMがアクセスできるようにしたい場合があります。 この場合、インデックス作成はオンラインで実行し、メインアプリケーションの一部にする必要があります。
インデックス作成ステージの簡略化された図は次のとおりです:
検索
検索ステージは通常オンラインで発生し、ユーザーがインデックスされたドキュメントを使用して回答すべき質問を送信したときに発生します。
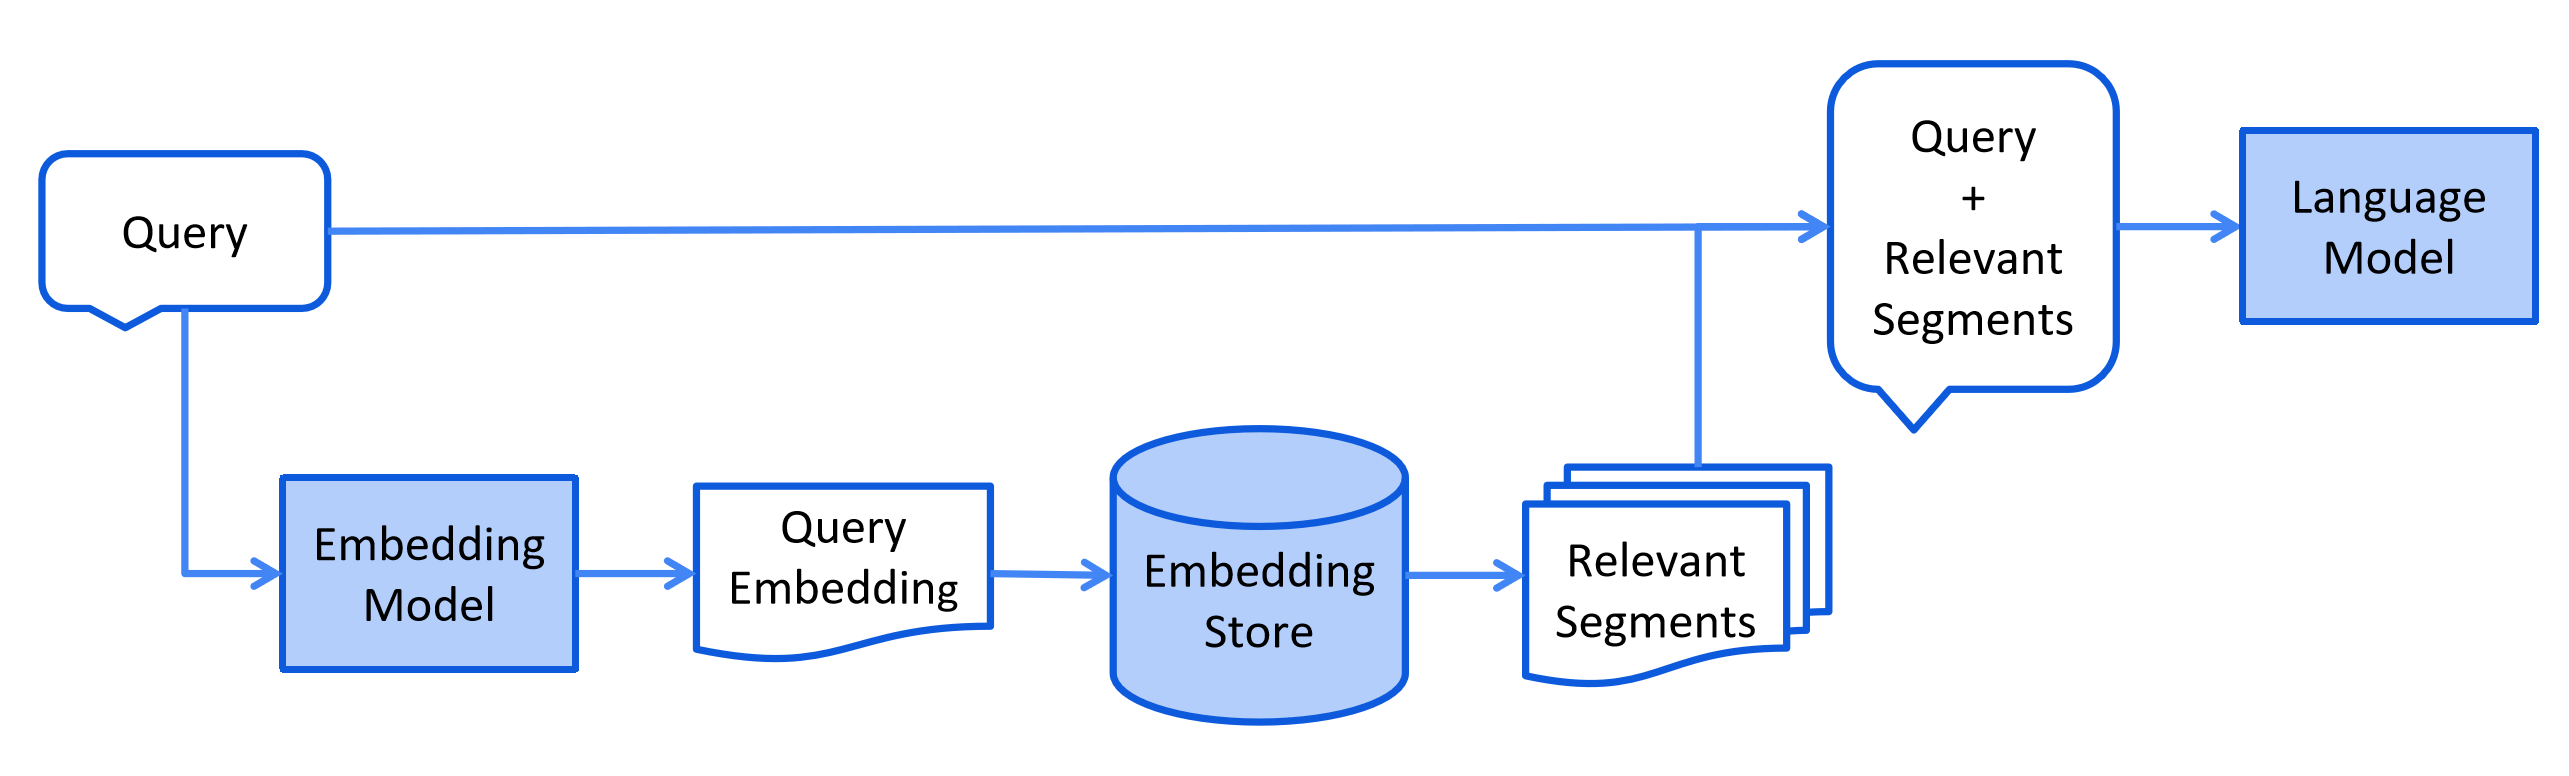
このプロセスは、使用される情報検索方法によって異なります。 ベクトル検索の場合、通常、ユーザーのクエリ(質問)の埋め込みと、 埋め込みストアでの類似性検索の実行が含まれます。 関連するセグメント(元のドキュメントの一部)がプロンプトに注入され、LLMに送信されます。
検索ステージの簡略化された図は次のとおりです:
LangChain4j の RAG の種類
LangChain4jは、RAGの3つの種類を提供します:
- Easy RAG:RAGを始める最も簡単な方法
- Naive RAG:ベクトル検索を使用したRAGの基本的な実装
- Advanced RAG:クエリ変換、複数ソースからの検索、再ランキングなどの追加ステップを可能にするモジュール式RAGフレームワーク
Easy RAG
LangChain4jには「Easy RAG」機能があり、RAGをできるだけ簡単に始められます。 埋め込みについて学んだり、ベクトルストアを選択したり、適切な埋め込みモデルを見つけたり、 ドキュメントの解析方法や分割方法を理解したりする必要はありません。 ドキュメントを指定するだけで、LangChain4jが魔法のように処理します。
カスタマイズ可能なRAGが必要な場合は、次のセクションに進んでください。
Quarkusを使用している場合は、Easy RAGをさらに簡単に行う方法があります。 Quarkusドキュメントをお読みください。
このような「Easy RAG」の品質は、もちろん、カスタマイズされたRAGセットアップよりも低くなります。 ただし、これはRAGについて学び始めたり、概念実証(PoC)を作成したりする最も簡単な方法です。 後で、Easy RAGからより高度なRAGへスムーズに移行し、さまざまな側面を調整およびカスタマイズできるようになります。
langchain4j-easy-rag依存関係をインポートします:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-easy-rag</artifactId>
    <version>1.18.1-beta28</version>
</dependency>
- ドキュメントを読み込みましょう:
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j/documentation");
指定されたディレクトリからすべてのファイルを読み込みます。
内部では何が行われているのでしょうか?
多種多様なドキュメントタイプをサポートするApache Tikaライブラリを使用して、
ドキュメントタイプの検出と解析が行われます。
使用するDocumentParserを明示的に指定しなかったため、
FileSystemDocumentLoaderはlangchain4j-easy-rag依存関係からSPIを通じて提供される
ApacheTikaDocumentParserを読み込みます。
ドキュメントの読み込みをカスタマイズするには?
すべてのサブディレクトリからドキュメントを読み込みたい場合は、loadDocumentsRecursivelyメソッドを使用できます。
List<Document> documents = FileSystemDocumentLoader.loadDocumentsRecursively("/home/langchain4j/documentation");
さらに、globや正規表現を使用してドキュメントをフィルタリングすることもできます。
PathMatcher pathMatcher = FileSystems.getDefault().getPathMatcher("glob:*.pdf");
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j/documentation", pathMatcher);
loadDocumentsRecursively メソッドを使用する場合、glob では単一のアスタリスクではなく二重アスタリスクを使用する必要がある場合があります: glob:**.pdf。
- 次に、ドキュメントを前処理し、専用の埋め込みストア(ベクターデータベースとも呼ばれます)に保存する必要があります。 これは、ユーザーが質問したときに、関連する情報をすばやく見つけるために必要です。 当社がサポートする30以上の埋め込みストアのいずれかを使用できますが、 ここでは簡単にするために、インメモリのものを使用します。
InMemoryEmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>();
EmbeddingStoreIngestor.ingest(documents, embeddingStore);
内部では何が起きているのでしょうか?
-
EmbeddingStoreIngestorは、SPIを通じてlangchain4j-easy-rag依存関係からDocumentSplitterを読み込みます。 各Documentは、それぞれ最大300トークン、30トークンのオーバーラップを持つ小さな断片(TextSegment)に分割されます。 -
EmbeddingStoreIngestorは、SPIを通じてlangchain4j-easy-rag依存関係からEmbeddingModelを読み込みます。 各TextSegmentは、EmbeddingModelを使用してEmbeddingに変換されます。
Easy RAGのデフォルトの埋め込みモデルとして、bge-small-en-v1.5を選択しました。
このモデルはMTEBリーダーボードで優れたスコアを達成しており、 量子化バージョンはわずか24メガバイトの容量しか占有しません。 そのため、ONNX Runtimeを使用してメモリに簡単に読み込み、同じプロセス内で実行できます。
そうです、外部サービスを一切使わずに、同じJVMプロセス内で完全にオフラインでテキストを埋め込みに変換できるのです。 LangChain4jは、いくつかの人気のある埋め込みモデルを そのまま利用できる形で提供しています。
- すべての
TextSegmentとEmbeddingのペアは、EmbeddingStoreに保存されます。
- 最後のステップは、LLMへのAPIとして機能するAIサービスを作成することです。
interface Assistant {

    String chat(String userMessage);
}

ChatModel chatModel = OpenAiChatModel.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .modelName(GPT_4_O_MINI)
    .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(chatModel)
    .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
    .contentRetriever(EmbeddingStoreContentRetriever.from(embeddingStore))
    .build();
ここでは、Assistantがユーザーの質問に回答するためにOpenAI LLMを使用し、会話内の最新10件のメッセージを記憶し、ドキュメントを含むEmbeddingStoreから関連コンテンツを取得するように設定します。
- そして、これでチャットを始める準備ができました!
String answer = assistant.chat("How to do Easy RAG with LangChain4j?");
コア RAG API
LangChain4jは、シンプルなものから高度なものまで、カスタムRAGパイプラインを簡単に構築できるようにするための豊富なAPIセットを提供しています。 このセクションでは、主要なドメインクラスとAPIについて説明します。
Document
Documentクラスは、単一のPDFファイルやWebページなど、ドキュメント全体を表します。
現時点では、Documentはテキスト情報のみを表すことができますが、
将来のアップデートでは画像やテーブルもサポートする予定です。
便利なメソッド
Document.text()はDocumentのテキストを返しますDocument.metadata()はDocumentのMetadataを返します(下記の「Metadata」セクションを参照)Document.toTextSegment()はDocumentをTextSegmentに変換します(下記の「TextSegment」セクションを参照)Document.from(String, Metadata)はテキストとMetadataからDocumentを作成しますDocument.from(String)は空のMetadataを持つテキストからDocumentを作成します
Metadata
各DocumentにはMetadataが含まれています。
これは、ドキュメントの名前、ソース、最終更新日、所有者、
その他の関連する詳細情報など、Documentに関するメタ情報を格納します。
Metadataはキーと値のマップとして格納され、キーはString型で、
値はString、Integer、Long、Float、Double、UUIDのいずれかの型になります。
Metadataはいくつかの理由で役立ちます:
- LLMへのプロンプトに
Documentのコンテンツを含める際に、 メタデータエントリも含めることで、LLMに考慮すべき追加情報を提供できます。 例えば、Documentの名前とソースを提供することで、LLMのコンテンツ理解を向上させることができます。 - プロンプトに含める関連コンテンツを検索する際に、
Metadataエントリでフィルタリングできます。 例えば、セマンティック検索を特定の所有者に属するDocumentのみに絞り込むことができます。 Documentのソースが更新された場合(例えば、ドキュメントの特定のページ)、 メタデータエントリ(例えば、「id」、「source」など)によって対応するDocumentを簡単に見つけ出し、EmbeddingStore内のものも更新して同期を保つことができます。
便利なメソッド
Metadata.from(Map)はMapからMetadataを作成しますMetadata.put(String key, String value)/put(String, int)などは、Metadataにエントリを追加しますMetadata.putAll(Map)はMetadataに複数のエントリを追加しますMetadata.getString(String key)/getInteger(String key)などは、Metadataエントリの値を返し、必要な型にキャストしますMetadata.containsKey(String key)はMetadataに指定されたキーのエントリが含まれているかを確認しますMetadata.remove(String key)はキーによってMetadataからエントリを削除しますMetadata.copy()はMetadataのコピーを返しますMetadata.toMap()はMetadataをMapに変換しますMetadata.merge(Metadata)は現在のMetadataを別のMetadataとマージします
Document Loader
StringからDocumentを作成することもできますが、より簡単な方法は、ライブラリに含まれているドキュメントローダーのいずれかを使用することです:
langchain4jモジュールのFileSystemDocumentLoaderlangchain4jモジュールのClassPathDocumentLoaderlangchain4jモジュールのUrlDocumentLoaderlangchain4j-document-loader-amazon-s3モジュールのAmazonS3DocumentLoaderlangchain4j-document-loader-azure-storage-blobモジュールのAzureBlobStorageDocumentLoaderlangchain4j-document-loader-githubモジュールのGitHubDocumentLoaderlangchain4j-document-loader-google-cloud-storageモジュールのGoogleCloudStorageDocumentLoaderlangchain4j-document-loader-seleniumモジュールのSeleniumDocumentLoaderlangchain4j-document-loader-playwrightモジュールのPlaywrightDocumentLoaderlangchain4j-document-loader-tencent-cosモジュールのTencentCosDocumentLoader
Document Parser
Documentは、PDF、DOC、TXTなど、さまざまな形式のファイルを表すことができます。
これらの各形式を解析するために、ライブラリに含まれている複数の実装を持つDocumentParserインターフェースがあります:
langchain4jモジュールのTextDocumentParser。プレーンテキスト形式(TXT、HTML、MDなど)のファイルを解析できますlangchain4j-document-parser-apache-pdfboxモジュールのApachePdfBoxDocumentParser。PDFファイルを解析できますlangchain4j-document-parser-apache-poiモジュールのApachePoiDocumentParser。MS Officeファイル形式 (DOC、DOCX、PPT、PPTX、XLS、XLSXなど)を解析できますlangchain4j-document-parser-apache-tikaモジュールのApacheTikaDocumentParser。 ほぼすべての既存ファイル形式を自動的に検出して解析できますlangchain4j-document-parser-doclingモジュールのDoclingDocumentParser。 Docling JavaとDoclingを使用してドキュメントを処理しますlangchain4j-document-parser-markdownモジュールのMarkdownDocumentParser。 マークダウン形式のファイルを解析できますlangchain4j-document-parser-yamlモジュールのYamlDocumentParser。 YAML形式のファイルを解析できます
ファイルシステムから1つまたは複数のDocumentをロードする方法の例は次のとおりです:
// Load a single document
Document document = FileSystemDocumentLoader.loadDocument("/home/langchain4j/file.txt", new TextDocumentParser());

// Load all documents from a directory
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j", new TextDocumentParser());

// Load all *.txt documents from a directory
PathMatcher pathMatcher = FileSystems.getDefault().getPathMatcher("glob:*.txt");
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j", pathMatcher, new TextDocumentParser());

// Load all documents from a directory and its subdirectories
List<Document> documents = FileSystemDocumentLoader.loadDocumentsRecursively("/home/langchain4j", new TextDocumentParser());
DocumentParserを明示的に指定せずにドキュメントを読み込むこともできます。
この場合、デフォルトのDocumentParserが使用されます。
デフォルトのパーサーはSPIを通じて読み込まれます(例:langchain4j-document-parser-apache-tikaやlangchain4j-easy-ragがインポートされている場合)。
SPIを通じてDocumentParserが見つからない場合は、フォールバックとしてTextDocumentParserが使用されます。
Document Transformer
DocumentTransformerの実装は、以下のようなさまざまなドキュメント変換を実行できます:
- クリーニング:
Documentのテキストから不要なノイズを除去します。これにより、トークンを節約し、ノイズによる干渉を減らすことができます。 - フィルタリング:特定の
Documentを検索対象から完全に除外します。 - エンリッチメント:検索結果を向上させる可能性がある追加情報を
Documentに付加します。 - 要約:
Documentを要約し、その短い要約をMetadataに保存して、後で各TextSegment(後述)に含めることで、検索を改善できる可能性があります。 - など。
この段階で、Metadataエントリの追加、変更、削除も行えます。
現在、標準で提供されている実装は、langchain4j-document-transformer-jsoupモジュールのHtmlToTextDocumentTransformerのみです。
これは、生のHTMLから必要なテキストコンテンツとメタデータエントリを抽出できます。
万能な解決策はないため、独自のデータに合わせてカスタマイズしたDocumentTransformerを独自に実装することをお勧めします。
Graph Transformer
GraphTransformerは、非構造化Documentオブジェクトを、ノードやリレーションシップなどのセマンティックグラフ要素を抽出して構造化GraphDocumentに変換するインターフェースです。
生のテキストを構造化されたセマンティックグラフに変換するのに最適です。
GraphTransformerは、生のドキュメントをGraphDocumentに変換します。これには以下が含まれます:
- テキスト内のエンティティや概念を表すノード(
GraphNode)のセット。 - それらのエンティティがどのように接続されているかを表すリレーションシップ(
GraphEdge)のセット。 - ソースとしての元の
Document。
デフォルトの実装はLLMGraphTransformerで、言語モデル(例:OpenAI)を使用して、プロンプトエンジニアリングにより自然言語からグラフ情報を抽出します。
主な利点
- エンティティとリレーションシップの抽出:主要な概念とその意味的なつながりを特定します。
- グラフ表現:出力はナレッジグラフやグラフデータベースへの統合にすぐに使用できます。
- モデル駆動型パース:大規模言語モデルを使用して、非構造化テキストから構造を推論します。
Maven依存関係
<dependency>
  <groupId>dev.langchain4j</groupId>
  <artifactId>langchain4j-community-llm-graph-transformer</artifactId>
  <version>${latest version here}</version>
</dependency>
使用例
import dev.langchain4j.data.document.Document;
import dev.langchain4j.model.openai.OpenAiChatModel;
import dev.langchain4j.community.data.document.graph.GraphDocument;
import dev.langchain4j.community.data.document.graph.GraphNode;
import dev.langchain4j.community.data.document.graph.GraphEdge;
import dev.langchain4j.community.data.document.transformer.graph.GraphTransformer;
import dev.langchain4j.community.data.document.transformer.graph.llm.LLMGraphTransformer;

import java.time.Duration;
import java.util.Set;

public class GraphTransformerExample {
    public static void main(String[] args) {
        // Create a GraphTransformer backed by an LLM
        GraphTransformer transformer = new LLMGraphTransformer(
            OpenAiChatModel.builder()
                .apiKey(System.getenv("OPENAI_API_KEY"))
                .timeout(Duration.ofSeconds(60))
                .build()
        );

        // Input document
        Document document = Document.from("Barack Obama was born in Hawaii and served as the 44th President of the United States.");

        // Transform the document
        GraphDocument graphDocument = transformer.transform(document);

        // Access nodes and relationships
        Set<GraphNode> nodes = graphDocument.nodes();
        Set<GraphEdge> relationships = graphDocument.relationships();

        nodes.forEach(System.out::println);
        relationships.forEach(System.out::println);
    }
}
出力例
GraphNode(name=Barack Obama, type=Person)
GraphNode(name=Hawaii, type=Location)
GraphEdge(from=Barack Obama, predicate=was born in, to=Hawaii)

GraphEdge(from=Barack Obama, predicate=served as, to=President of the United States)
テキストセグメント
Documentの読み込みが完了したら、それをより小さなセグメント(チャンク)に分割(チャンキング)します。
LangChain4jのドメインモデルには、Documentのセグメントを表すTextSegmentクラスがあります。
名前が示すように、TextSegmentはテキスト情報のみを表すことができます。
分割すべきか、分割しないべきか?
プロンプトにナレッジベース全体ではなく、関連する少数のセグメントのみを含めたい理由はいくつかあります:
- LLMにはコンテキストウィンドウに制限があるため、ナレッジベース全体が収まらない可能性があります
- プロンプトに多くの情報を提供するほど、LLMが処理して応答するのに時間がかかります
- プロンプトに多くの情報を提供するほど、コストがかかります
- プロンプト内の無関係な情報はLLMの注意をそらし、幻覚(ハルシネーション)の可能性を高める可能性があります
- プロンプトに多くの情報を提供するほど、LLMがどの情報に基づいて応答したかを説明することが難しくなります
これらの懸念は、ナレッジベースをより小さく、より扱いやすいセグメントに分割することで対処できます。 それらのセグメントはどのくらいの大きさにすべきでしょうか?それは良い質問です。いつものように、状況によります。
現在、広く使用されている2つのアプローチがあります:
- 各ドキュメント(例:PDFファイル、Webページなど)は原子的で分割不可能です。
RAGパイプラインの検索中に、最も関連性の高いN個のドキュメントが取得され、プロンプトに注入されます。 ドキュメントはかなり長くなる可能性があるため、この場合、おそらく長いコンテキストを持つLLMを使用する必要があります。 このアプローチは、詳細を見逃す余裕がない場合など、完全なドキュメントの取得が重要な場合に適しています。
- 利点:コンテキストが失われることはありません。
- 欠点:
- より多くのトークンが消費されます。
- ドキュメントに複数のセクションやトピックが含まれる場合があり、そのすべてがクエリに関連するとは限りません。
- さまざまなサイズの完全なドキュメントが単一の固定長ベクトルに圧縮されるため、ベクトル検索の品質が低下します。
- ドキュメントは、章、段落、場合によっては文などのより小さなセグメントに分割されます。 RAGパイプラインの検索中に、最も関連性の高いN個のセグメントが取得され、プロンプトに注入されます。 課題は、各セグメントがLLMが理解するのに十分なコンテキストと情報を提供することを保証することです。
コンテキストが不足すると、LLMが与えられたセグメントを誤解し、幻覚を引き起こす可能性があります。 一般的な戦略は、ドキュメントをオーバーラップ付きのセグメントに分割することですが、これで問題が完全に解決するわけではありません。 ここで役立つ高度なテクニックがいくつかあります。例えば、「センテンスウィンドウ検索」、「自動マージ検索」、「親ドキュメント検索」などです。
ここでは詳細には触れませんが、基本的にこれらの方法は、取得されたセグメントの周囲のより多くのコンテキストを取得し、取得されたセグメントの前後の追加情報をLLMに提供します。
- 利点:
- ベクトル検索の品質が向上します。
- トークン消費量が削減されます。
- 欠点:一部のコンテキストが失われる可能性があります。
便利なメソッド
TextSegment.text()はTextSegmentのテキストを返しますTextSegment.metadata()はTextSegmentのMetadataを返しますTextSegment.from(String, Metadata)はテキストとMetadataからTextSegmentを作成しますTextSegment.from(String)は空のMetadataを持つテキストからTextSegmentを作成します
ドキュメントスプリッター
LangChain4jには、すぐに使用できるいくつかの実装を備えたDocumentSplitterインターフェースがあります:
DocumentByParagraphSplitterDocumentByLineSplitterDocumentBySentenceSplitterDocumentByWordSplitterDocumentByCharacterSplitterDocumentByRegexSplitter- 再帰的:
DocumentSplitters.recursive(...)
これらはすべて次のように動作します:
-
DocumentSplitterをインスタンス化し、TextSegmentの望ましいサイズと、オプションで文字またはトークン単位のオーバーラップを指定します。 -
DocumentSplitterのsplit(Document)またはsplitAll(List<Document>)メソッドを呼び出します。 -
DocumentSplitterは、指定されたDocumentをより小さな単位に分割します。その性質はスプリッターによって異なります。例えば、DocumentByParagraphSplitterはドキュメントを段落(2つ以上の連続する改行文字で定義)に分割し、DocumentBySentenceSplitterはOpenNLPライブラリの文検出器を使用してドキュメントを文に分割します。 -
DocumentSplitterは、これらのより小さな単位(段落、文、単語など)をTextSegmentに結合し、ステップ1で設定された制限を超えない範囲で、できるだけ多くの単位を単一のTextSegmentに含めようとします。一部の単位がまだ大きすぎてTextSegmentに収まらない場合は、サブスプリッターを呼び出します。これは、収まらない単位をより細かい単位に分割できる別のDocumentSplitterです。
すべてのMetadataエントリはDocumentから各TextSegmentにコピーされます。
一意のメタデータエントリ「index」が各テキストセグメントに追加されます。
最初のTextSegmentにはindex=0が含まれ、2番目にはindex=1が含まれ、以降同様に続きます。
テキストセグメントトランスフォーマー
TextSegmentTransformerはDocumentTransformer(上記で説明)に似ていますが、TextSegmentを変換します。
DocumentTransformerと同様に、万能の解決策はないため、独自のデータに合わせてカスタマイズしたTextSegmentTransformerを実装することをお勧めします。
検索品質の向上に非常に効果的なテクニックの1つは、各TextSegmentにDocumentのタイトルまたは短い要約を含めることです。
埋め込み(Embedding)
Embeddingクラスは、埋め込まれたコンテンツ(通常はTextSegmentなどのテキスト)の「意味的意味」を表す数値ベクトルをカプセル化します。
ベクトル埋め込みの詳細については、以下を参照してください:
- https://www.elastic.co/what-is/vector-embedding
- https://www.pinecone.io/learn/vector-embeddings/
- https://cloud.google.com/blog/topics/developers-practitioners/meet-ais-multitool-vector-embeddings
便利なメソッド
Embedding.dimension()は埋め込みベクトルの次元(その長さ)を返しますCosineSimilarity.between(Embedding, Embedding)は2つのEmbedding間のコサイン類似度を計算しますEmbedding.normalize()は埋め込みベクトルを正規化します(インプレース)
埋め込みモデル
EmbeddingModelインターフェースは、テキストをEmbeddingに変換する特別なタイプのモデルを表します。
現在サポートされている埋め込みモデルは、こちらにあります。
便利なメソッド
EmbeddingModel.embed(String)は指定されたテキストを埋め込みますEmbeddingModel.embed(TextSegment)は指定されたTextSegmentを埋め込みますEmbeddingModel.embedAll(List<TextSegment>)は指定されたすべてのTextSegmentを埋め込みますEmbeddingModel.dimension()はこのモデルによって生成されるEmbeddingの次元を返します
リクエスト/レスポンスAPIと呼び出しごとのパラメータ
上記の便利なメソッドに加えて、EmbeddingModelはEmbeddingRequestを受け入れ、EmbeddingResponseを返します。これにより、呼び出しごとのパラメータを渡すことができます:
EmbeddingResponse response = embeddingModel.embed(EmbeddingRequest.builder()
    .input("What is the capital of France?")
    .inputType(EmbeddingInputType.QUERY) // query vs document, see the section below
    .dimensions(256)                     // reduce output dimensionality (on models that support it)
    .build());

List<Embedding> embeddings = response.embeddings();
呼び出しごとのパラメータは厳密にオプトイン方式です。各プロバイダーは、supportedParameters() を通じてサポート内容を宣言します。
リクエストがモデルでサポートされていないパラメータを使用した場合、UnsupportedFeatureException が即座にスローされ、静かに無視されることはありません。詳細は
クエリ埋め込みとドキュメント埋め込み も参照してください。
マルチモーダル埋め込み
一部のモデルは、画像(およびテキストと画像が混在した入力)を同じベクトル空間に埋め込みます。Content
パーツから入力を構築します。これをサポートするモデル(Cohere Embed v4、Voyage multimodal、Google Gemini Embedding 2、Amazon Titan
Multimodal、Jina CLIP など)では、パーツが単一の埋め込みに融合されます。
EmbeddingResponse response = embeddingModel.embed(EmbeddingRequest.builder()
    .input(TextContent.from("a photo of a cat"), ImageContent.from("https://example.com/cat.png"))
    .build());
モデルは、supportedContentTypes() を介してサポートするモダリティを宣言します。テキストのみのモデルに画像を渡すと、UnsupportedFeatureException で即座に失敗します。EmbeddingModel のオブザーバビリティ(リスナー)については、オブザーバビリティ チュートリアルで説明されています。
埋め込みストア
EmbeddingStore インターフェースは、Embedding のストア(ベクトルデータベースとも呼ばれます)を表します。
これにより、類似した(埋め込み空間内で近い)Embedding の保存と効率的な検索が可能になります。
現在サポートされている埋め込みストアは、こちら にあります。
EmbeddingStore は、Embedding のみ、または対応する TextSegment と一緒に保存できます:
- ID によって
Embeddingのみを保存できます。元の埋め込みデータは別の場所に保存し、ID を使用して関連付けることができます。 Embeddingと、埋め込まれた元のデータ(通常はTextSegment)の両方を保存できます。
便利なメソッド
EmbeddingStore.add(Embedding)は、指定されたEmbeddingをストアに追加し、ランダムな ID を返しますEmbeddingStore.add(String id, Embedding)は、指定された ID を持つEmbeddingをストアに追加しますEmbeddingStore.add(Embedding, TextSegment)は、関連付けられたTextSegmentを持つEmbeddingをストアに追加し、ランダムな ID を返しますEmbeddingStore.addAll(List<Embedding>)は、指定されたEmbeddingのリストをストアに追加し、ランダムな ID のリストを返しますEmbeddingStore.addAll(List<Embedding>, List<TextSegment>)は、関連付けられたTextSegmentを持つEmbeddingのリストをストアに追加し、ランダムな ID のリストを返しますEmbeddingStore.addAll(List<String> ids, List<Embedding>, List<TextSegment>)は、関連付けられた ID とTextSegmentを持つEmbeddingのリストをストアに追加しますEmbeddingStore.search(EmbeddingSearchRequest)は、最も類似したEmbeddingを検索しますEmbeddingStore.remove(String id)は、ID によって単一のEmbeddingをストアから削除しますEmbeddingStore.removeAll(Collection<String> ids)は、指定されたコレクションに ID が存在するすべてのEmbeddingをストアから削除しますEmbeddingStore.removeAll(Filter)は、指定されたFilterに一致するすべてのEmbeddingをストアから削除しますEmbeddingStore.removeAll()は、すべてのEmbeddingをストアから削除します
EmbeddingSearchRequest
EmbeddingSearchRequest は、EmbeddingStore 内を検索するためのリクエストを表します。
以下の属性があります:
Embedding queryEmbedding: 参照として使用される埋め込み。int maxResults: 返す結果の最大数。オプションのパラメータです。デフォルト:3。double minScore: 最小スコア(0 から 1 まで、両端を含む)。スコアがminScore以上の埋め込みのみが返されます。オプションのパラメータです。デフォルト:0。Filter filter: 検索中にMetadataに適用されるフィルター。MetadataがFilterに一致するTextSegmentのみが返されます。
Filter
Filter を使用すると、ベクトル検索を実行する際に Metadata エントリによるフィルタリングが可能になります。
現在、以下の Filter タイプ/操作がサポートされています:
IsEqualToIsNotEqualToIsGreaterThanIsGreaterThanOrEqualToIsLessThanIsLessThanOrEqualToIsInIsNotInContainsStringAndNotOr
すべての埋め込みストアが Metadata によるフィルタリングをサポートしているわけではありません。
「Metadata によるフィルタリング」列については、こちら を参照してください。
Metadata によるフィルタリングをサポートしているストアでも、すべての Filter タイプ/操作をサポートしているわけではありません。
たとえば、ContainsString は現在、Milvus、PgVector、Qdrant でのみサポートされています。
Filter の詳細については、こちら を参照してください。
EmbeddingSearchResult
EmbeddingSearchResult は、EmbeddingStore 内の検索結果を表します。
EmbeddingMatch のリストが含まれています。
Embedding Match
EmbeddingMatch は、関連性スコア、ID、および元の埋め込みデータ(通常は TextSegment)とともに、一致した Embedding を表します。
埋め込みストアインジェスター
EmbeddingStoreIngestor は、取り込みパイプラインを表し、Document を EmbeddingStore に取り込む役割を担います。
最も単純な構成では、EmbeddingStoreIngestor は、指定された EmbeddingModel を使用して提供された Document を埋め込み、それらの Embedding とともに指定された EmbeddingStore に保存します:
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()
        .embeddingModel(embeddingModel)
        .embeddingStore(embeddingStore)
        .build();

ingestor.ingest(document1);
ingestor.ingest(document2, document3);
IngestionResult ingestionResult = ingestor.ingest(List.of(document4, document5, document6));
EmbeddingStoreIngestor のすべての ingest() メソッドは IngestionResult を返します。
IngestionResult には有用な情報が含まれており、その中には TokenUsage もあり、埋め込みに使用されたトークン数を示します。
オプションとして、EmbeddingStoreIngestor は指定された DocumentTransformer を使用して Document を変換できます。
これは、埋め込み前に Document をクリーンアップ、拡充、またはフォーマットしたい場合に役立ちます。
オプションとして、EmbeddingStoreIngestor は指定された DocumentSplitter を使用して Document を TextSegment に分割できます。
これは、Document が大きく、類似性検索の品質を向上させ、LLM に送信するプロンプトのサイズとコストを削減するために、より小さな TextSegment に分割したい場合に役立ちます。
オプションとして、EmbeddingStoreIngestor は指定された TextSegmentTransformer を使用して TextSegment を変換できます。
これは、埋め込み前に TextSegment をクリーンアップ、拡充、またはフォーマットしたい場合に役立ちます。
例:
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()

    // adding userId metadata entry to each Document to be able to filter by it later
    .documentTransformer(document -> {
        document.metadata().put("userId", "12345");
        return document;
    })

    // splitting each Document into TextSegments of 1000 tokens each, with a 200-token overlap
    .documentSplitter(DocumentSplitters.recursive(1000, 200, new OpenAiTokenCountEstimator("gpt-4o-mini")))

    // adding a name of the Document to each TextSegment to improve the quality of search
    .textSegmentTransformer(textSegment -> TextSegment.from(
            textSegment.metadata().getString("file_name") + "\n" + textSegment.text(),
            textSegment.metadata()
    ))

    .embeddingModel(embeddingModel)
    .embeddingStore(embeddingStore)
    .build();
クエリ埋め込みとドキュメント埋め込み(オプトイン)
一部の埋め込みモデル(例:Cohere Embed v4、Voyage、Google)では、ドキュメントとクエリを異なる方法で埋め込むと、検索品質が向上します。EmbeddingStoreIngestor では入力タイプを DOCUMENT(インデックス化するセグメント用)に、EmbeddingStoreContentRetriever では QUERY(クエリ用、Embedding Store Content Retriever を参照)に宣言することで、オプトインできます。
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()
    .embeddingModel(embeddingModel)
    .embeddingStore(embeddingStore)
    .embeddingInputType(EmbeddingInputType.DOCUMENT)
    .build();
embeddingInputTypeが設定されていない場合、入力タイプは送信されません。設定されている場合、選択したEmbeddingModelが入力タイプのパラメータをサポートしている必要があります(そのsupportedParameters()を参照)。サポートされていない場合、埋め込みはUnsupportedFeatureExceptionで即座に失敗します。
Naive RAG
ドキュメントが取り込まれたら(前のセクションを参照)、EmbeddingStoreContentRetrieverを作成してナイーブRAG機能を有効にできます。
AIサービスを使用する場合、ナイーブRAGは次のように設定できます:
ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .maxResults(5)
    .minScore(0.75)
    .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(model)
    .contentRetriever(contentRetriever)
    .build();
Advanced RAG
高度なRAGは、LangChain4jを使用して以下の主要コンポーネントで実装できます:
QueryTransformerQueryRouterContentRetrieverContentAggregatorContentInjector
次の図は、これらのコンポーネントがどのように連携するかを示しています:
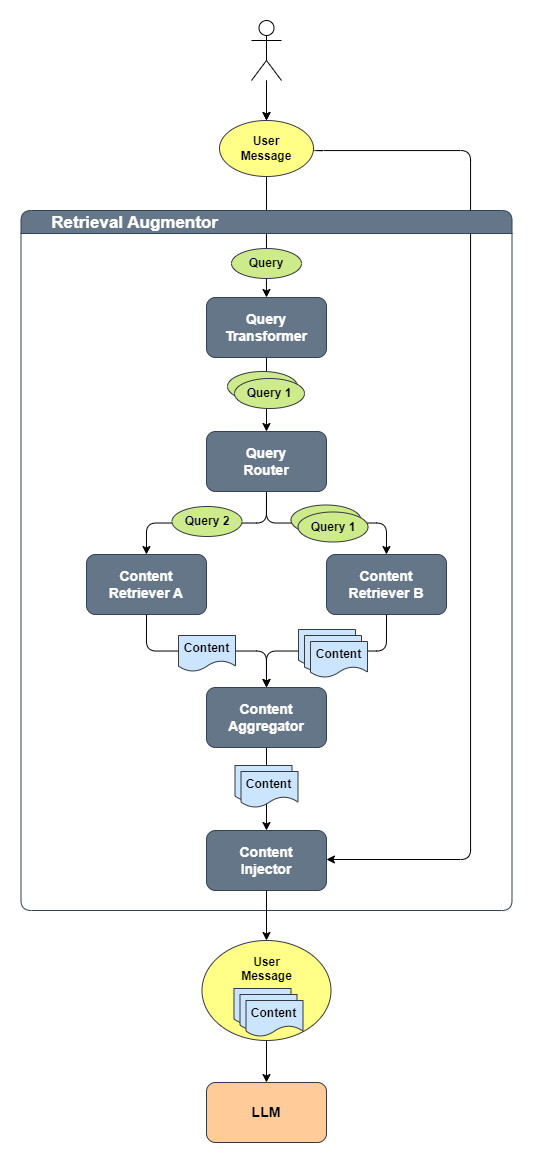
プロセスは以下の通りです:
- ユーザーが
UserMessageを生成し、それがQueryに変換されます QueryTransformerがQueryを1つまたは複数のQueryに変換します- 各
QueryはQueryRouterによって1つまたは複数のContentRetrieverにルーティングされます - 各
ContentRetrieverが各Queryに関連するContentを取得します ContentAggregatorが取得したすべてのContentを単一の最終的なランキングリストに結合します- この
Contentのリストが元のUserMessageに注入されます - 最後に、元のクエリと注入された関連コンテンツを含む
UserMessageがLLMに送信されます
詳細については、各コンポーネントのJavadocを参照してください。
検索オーグメンター
RetrievalAugmentorはRAGパイプラインへのエントリーポイントです。
さまざまなソースから取得された関連ContentでChatMessageを拡張する役割を担います。
RetrievalAugmentorのインスタンスは、AIサービスの作成時に指定できます。
Assistant assistant = AiServices.builder(Assistant.class)
    ...
    .retrievalAugmentor(retrievalAugmentor)
    .build();
AIサービスが呼び出されるたびに、指定されたRetrievalAugmentorが呼び出され、現在のUserMessageを拡張します。
RetrievalAugmentorのデフォルト実装(後述)を使用することも、カスタム実装を作成することもできます。
デフォルトのRetrievalAugmentor
LangChain4jは、RetrievalAugmentorインターフェースのすぐに使える実装であるDefaultRetrievalAugmentorを提供しています。これは、ほとんどのRAGユースケースに適しているはずです。
この実装は、こちらの記事とこちらの論文に着想を得ています。
コンセプトをより深く理解するために、これらのリソースを確認することをお勧めします。
Query
Queryは、RAGパイプラインにおけるユーザークエリを表します。
クエリのテキストとクエリメタデータが含まれます。
クエリメタデータ
Query内のMetadataには、RAGパイプラインのさまざまなコンポーネントで役立つ可能性のある情報が含まれています。例えば、以下のとおりです。
Metadata.userMessage()- 拡張される元のUserMessageMetadata.chatMemoryId()-@MemoryIdアノテーションが付けられたメソッドパラメータの値。詳細はこちら。ユーザーを識別し、取得中にアクセス制限やフィルタを適用するために使用できます。Metadata.chatMemory()- これまでのすべてのChatMessage。Queryが行われたコンテキストを理解するのに役立ちます。Metadata.invocationParameters()- AIサービスを呼び出す際に指定できるInvocationParametersが含まれます。
interface Assistant {
    String chat(@UserMessage String userMessage, InvocationParameters parameters);
}

InvocationParameters parameters = InvocationParameters.from(Map.of("userId", "12345"));
String response = assistant.chat("Hello", parameters);
InvocationParameters は、他のAIサービスコンポーネント内でもアクセスできます。例えば、以下のようなものがあります:
@Toolアノテーション付きメソッドToolProvider:ToolProviderRequest内ToolArgumentsErrorHandlerおよびToolExecutionErrorHandler:ToolErrorContext内
パラメータは、変更可能でスレッドセーフな Map に格納されます。
データは、AIサービスの1回の呼び出し中に、InvocationParameters 内でAIサービスコンポーネント間を渡すことができます
(例えば、あるRAGコンポーネントから別のRAGコンポーネントへ、またはRAGコンポーネントからツールへ)。
クエリトランスフォーマー
QueryTransformer は、指定された Query を1つまたは複数の Query に変換します。
その目的は、元の Query を変更または拡張することで、検索品質を向上させることです。
検索を改善するための既知のアプローチには、以下のようなものがあります:
- クエリ圧縮
- クエリ拡張
- クエリ書き換え
- ステップバックプロンプティング
- 仮説文書埋め込み(HyDE)
詳細はこちらをご覧ください。
LangChain4jには、RepeatingQueryTransformer を提供するオプションのコミunity Prompt Repetition モジュールもあります。これは、コンテンツ取得前に検索クエリを繰り返し、モデルに送信される最終的な拡張プロンプトではなく、クエリ自体を変換するために使用する必要があります。
デフォルトクエリトランスフォーマー
DefaultQueryTransformer は、DefaultRetrievalAugmentor で使用されるデフォルトの実装です。
Query に変更を加えず、そのまま通過させるだけです。
圧縮クエリトランスフォーマー
CompressingQueryTransformer は、LLMを使用して、指定された Query と以前の会話を、スタンドアロンの Query に圧縮します。
これは、ユーザーが以前の質問や回答の情報を参照するフォローアップ質問をする場合に役立ちます。
以下に例を示します:
User: Tell me about John Doe
AI: John Doe was a ...
User: Where did he live?
クエリ「Where did he live?」だけでは、必要な情報を取得できません。
ジョン・ドウへの明示的な言及がないため、heが誰を指しているのか不明瞭だからです。
CompressingQueryTransformerを使用すると、LLMが会話全体を読み取り、
「Where did he live?」を「Where did John Doe live?」に変換します。
Expanding Query Transformer
ExpandingQueryTransformerは、LLMを使用して指定されたQueryを複数のQueryに展開します。
LLMがQueryをさまざまな方法で言い換えたり再構成したりできるため、
より関連性の高いコンテンツを取得するのに役立ちます。
Content
Contentは、ユーザーのQueryに関連するコンテンツを表します。
現在はテキストコンテンツ(つまりTextSegment)に限定されていますが、
将来的には他のモダリティ(画像、音声、動画など)もサポートする可能性があります。
Content Retriever
ContentRetrieverは、指定されたQueryを使用して、基盤となるデータソースからContentを取得します。
基盤となるデータソースは、実質的に何でも可能です:
- 埋め込みストア
- 全文検索エンジン
- ベクトル検索と全文検索のハイブリッド
- Web検索エンジン
- ナレッジグラフ
- SQLデータベース
- など
ContentRetrieverによって返されるContentのリストは、関連性の高い順(最高から最低)に並べられます。
Embedding Store Content Retriever
EmbeddingStoreContentRetrieverは、EmbeddingModelを使用してQueryを埋め込み、
EmbeddingStoreから関連するContentを取得します。
以下に例を示します:
EmbeddingStore embeddingStore = ...
EmbeddingModel embeddingModel = ...

ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .maxResults(3)
     // maxResults can also be specified dynamically depending on the query
    .dynamicMaxResults(query -> 3)
    .minScore(0.75)
     // minScore can also be specified dynamically depending on the query
    .dynamicMinScore(query -> 0.75)
    .filter(metadataKey("userId").isEqualTo("12345"))
    // filter can also be specified dynamically depending on the query
    .dynamicFilter(query -> {
        String userId = query.metadata().invocationParameters().get("userId");
        return metadataKey("userId").isEqualTo(userId);
    })
    .build();

interface Assistant {
    String chat(@UserMessage String userMessage, InvocationParameters parameters);
}

InvocationParameters parameters = InvocationParameters.from(Map.of("userId", "12345"));
String response = assistant.chat("Hello", parameters);
クエリをinput_type=queryで埋め込むには(インジェスターのDOCUMENTとペアリングします。クエリとドキュメントの埋め込みを参照)、リトリーバーで入力タイプを設定します:
ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .embeddingInputType(EmbeddingInputType.QUERY)
    .build();
デフォルトは変更なし(入力タイプは送信されません)。EmbeddingModel は input_type パラメータをサポートしている必要があります。
Web検索コンテンツレトリーバー
WebSearchContentRetriever は、WebSearchEngine を使用してウェブから関連する Content を取得します。
サポートされているすべての WebSearchEngine 統合は、こちら にあります。
以下に例を示します:
WebSearchEngine googleSearchEngine = GoogleCustomWebSearchEngine.builder()
        .apiKey(System.getenv("GOOGLE_API_KEY"))
        .csi(System.getenv("GOOGLE_SEARCH_ENGINE_ID"))
        .build();

ContentRetriever contentRetriever = WebSearchContentRetriever.builder()
        .webSearchEngine(googleSearchEngine)
        .maxResults(3)
        .build();
完全な例はこちらにあります。
SQLデータベースコンテンツレトリーバー
SqlDatabaseContentRetrieverは、ContentRetrieverの実験的な実装であり、
langchain4j-experimental-sqlモジュールにあります。
これは、DataSourceとLLMを使用して、指定された自然言語のQueryに対して
SQLクエリを生成および実行します。
詳細については、SqlDatabaseContentRetrieverのjavadocを参照してください。
例はこちらです。
Azure AI Searchコンテンツレトリーバー
AzureAiSearchContentRetrieverは、
Azure AI Searchとの統合です。
全文検索、ベクトル検索、ハイブリッド検索、および再ランキングをサポートしています。
これは、langchain4j-azure-ai-searchモジュールにあります。
詳細については、AzureAiSearchContentRetrieverのJavadocを参照してください。
Neo4jコンテンツレトリーバー
Neo4jContentRetrieverは、Neo4jグラフデータベースとの統合です。
自然言語クエリをNeo4j Cypherクエリに変換し、
これらのクエリをNeo4jで実行して関連情報を取得します。
これは、langchain4j-community-neo4j-retrieverモジュールにあります。
Elasticsearchコンテンツレトリーバー
ElasticsearchContentRetrieverは、
Elasticsearchとの統合です。
全文検索、ベクトル検索、ハイブリッド検索をサポートしています。
これは、langchain4j-elasticsearchモジュールにあります。
詳細については、ElasticsearchContentRetrieverのJavadocを参照してください。
クエリルーター
QueryRouterは、Queryを適切なContentRetrieverにルーティングする役割を担います。
デフォルトクエリルーター
DefaultQueryRouterは、DefaultRetrievalAugmentorで使用されるデフォルトの実装です。
各Queryを設定されたすべてのContentRetrieverにルーティングします。
言語モデルクエリルーター
LanguageModelQueryRouterは、LLMを使用して指定されたQueryのルーティング先を決定します。
コンテンツアグリゲーター
ContentAggregatorは、以下の複数のランク付けされたContentリストを集約する役割を担います:
- 複数の
Query - 複数の
ContentRetriever - 両方
デフォルトコンテンツアグリゲーター
DefaultContentAggregatorは、ContentAggregatorのデフォルト実装であり、
2段階のReciprocal Rank Fusion(RRF)を実行します。
詳細については、DefaultContentAggregator Javadocを参照してください。
再ランキングコンテンツアグリゲーター
ReRankingContentAggregatorは、CohereなどのScoringModelを使用して再ランキングを実行します。
サポートされているスコアリング(再ランキング)モデルの完全なリストは
こちらにあります。
詳細については、ReRankingContentAggregator Javadocを参照してください。
コンテンツインジェクター
ContentInjectorは、ContentAggregatorによって返されたContentをUserMessageに注入する役割を担います。
デフォルトコンテンツインジェクター
DefaultContentInjectorは、ContentInjectorのデフォルト実装であり、単純にContentを
UserMessageの末尾にプレフィックスAnswer using the following information:を付けて追加します。
ContentをUserMessageに注入する方法は、次の3つの方法でカスタマイズできます:
- デフォルトの
PromptTemplateをオーバーライドする:
RetrievalAugmentor retrievalAugmentor = DefaultRetrievalAugmentor.builder()
    .contentInjector(DefaultContentInjector.builder()
        .promptTemplate(PromptTemplate.from("{{userMessage}}\n{{contents}}"))
        .build())
    .build();
PromptTemplateには{{userMessage}}と{{contents}}の変数が必ず含まれている必要があることにご注意ください。
DefaultContentInjectorを拡張し、formatメソッドのいずれかをオーバーライドする- カスタム
ContentInjectorを実装する
DefaultContentInjectorは、取得したContent.textSegment()からMetadataエントリの注入もサポートしています。
DefaultContentInjector.builder()
    .metadataKeysToInclude(List.of("source"))
    .build()
この場合、TextSegment.text() の先頭には「content: 」というプレフィックスが付加され、
Metadata の各値にはキーがプレフィックスとして付加されます。
最終的な UserMessage は次のようになります:
How can I cancel my reservation?

Answer using the following information:
content: To cancel a reservation, go to ...
source: ./cancellation_procedure.html

content: Cancellation is allowed for ...
source: ./cancellation_policy.html
並列化
Queryが1件かつContentRetrieverが1つの場合、
DefaultRetrievalAugmentorはクエリルーティングとコンテンツ取得を同じスレッドで実行します。
それ以外の場合は、Executorを使用して処理を並列化します。
デフォルトでは、変更された(keepAliveTimeが60秒ではなく1秒の)Executors.newCachedThreadPool()
が使用されますが、DefaultRetrievalAugmentorを作成する際にカスタムのExecutorインスタンスを提供することもできます。
DefaultRetrievalAugmentor.builder()
        ...
        .executor(executor)
        .build;
ソースへのアクセス
AIサービスを使用する際に、
メッセージを拡張するために取得されたソース(Content)にアクセスしたい場合は、
戻り値の型をResultクラスでラップすることで簡単に実現できます。
interface Assistant {

    Result<String> chat(String userMessage);
}

Result<String> result = assistant.chat("How to do Easy RAG with LangChain4j?");

String answer = result.content();
List<Content> sources = result.sources();
ストリーミング時には、onRetrieved()メソッドを使用してConsumer<List<Content>>を指定できます。
interface Assistant {

    TokenStream chat(String userMessage);
}

assistant.chat("How to do Easy RAG with LangChain4j?")
    .onRetrieved((List<Content> sources) -> ...)
    .onPartialResponse(...)
    .onCompleteResponse(...)
    .onError(...)
    .start();
チャットメモリに保存される内容の制御
AIサービスでRetrievalAugmentorを使用する場合、
拡張されたユーザーメッセージ(取得したContentが挿入されたもの)と
元のユーザーメッセージのどちらをチャットメモリに保存するかを制御できます。
この動作は、AiServicesビルダーのstoreRetrievedContentInChatMemoryオプションで設定します。
設定
-
true(デフォルト)
拡張されたUserMessage(元のクエリと取得したコンテンツ)を チャットメモリに保存します。
同じ拡張メッセージがLLMにも送信されます。 -
false
元のUserMessage(取得したコンテンツを含まない)のみを チャットメモリに保存します。
推論中は拡張メッセージが引き続きLLMに送信されます。
元のユーザーメッセージのみを保存すると、チャット履歴を簡潔に保ち、 ユーザーの実際の入力に沿った内容にすることができます。 その一方で、回答生成時にはLLMに取得したコンテキストを提供できます。
例
interface Assistant {

    String chat(String userMessage);
}

ChatModel chatModel = OpenAiChatModel.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .modelName(GPT_4_O_MINI)
    .build();

MessageWindowChatMemory chatMemory =
    MessageWindowChatMemory.withMaxMessages(10);

RetrievalAugmentor retrievalAugmentor =
    DefaultRetrievalAugmentor.builder()
        .contentRetriever(
            EmbeddingStoreContentRetriever.from(embeddingStore, embeddingModel))
        .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(chatModel)
    .chatMemory(chatMemory)
    .retrievalAugmentor(retrievalAugmentor)
    // Store only the original user message in chat memory
    .storeRetrievedContentInChatMemory(false)
    .build();